Journey to CS/머신러닝 17

원-핫 인코딩과 레이블 인코딩: 범주형 데이터 변환 기준과 실습

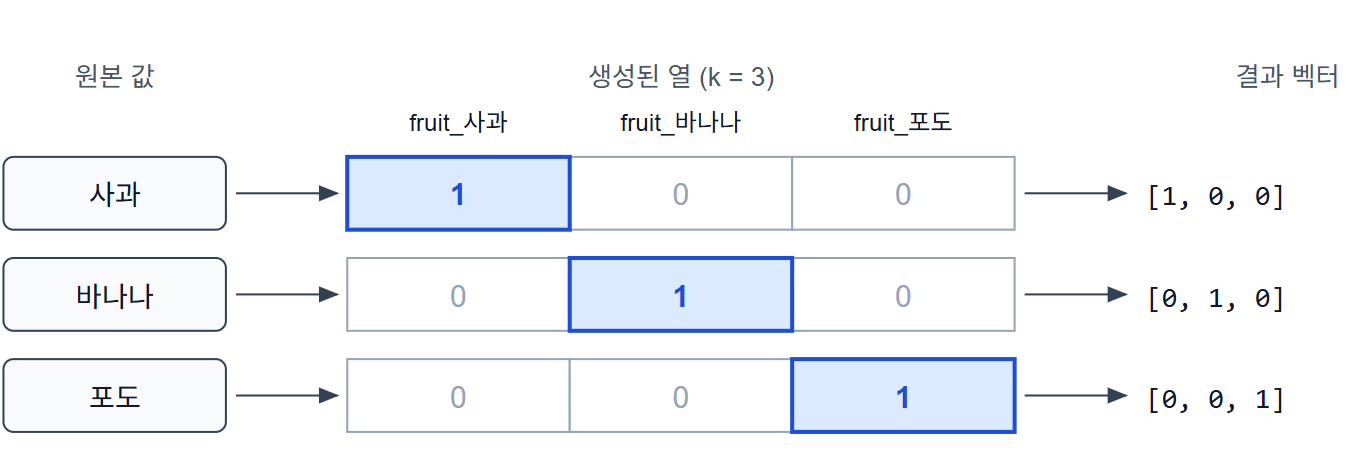
1. 범주형 데이터를 숫자로 바꿔야 하는 이유머신러닝 모델의 연산은 행렬 곱, 거리 계산, 미분으로 구성된다. 세 연산 모두 실수 입력을 전제하므로 "사과", "서울", "A형" 같은 문자열은 모델에 직접 투입할 수 없다. 따라서 범주형 데이터(categorical data)는 학습 전에 반드시 수치 벡터로 변환된다.변환 방식은 크게 두 가지다.레이블 인코딩(Label Encoding): 각 범주에 고유한 정수를 부여한다. 열 수는 그대로다.원-핫 인코딩(One-Hot Encoding): 범주마다 열을 만들고, 해당하는 하나의 열만 1, 나머지는 0으로 채운다.선택 기준은 취향이 아니라 두 가지 질문으로 결정된다.해당 변수에 순서(서열) 가 존재하는가?사용하는 모델이 숫자 값을 어떻게 소비하는가? (거리..
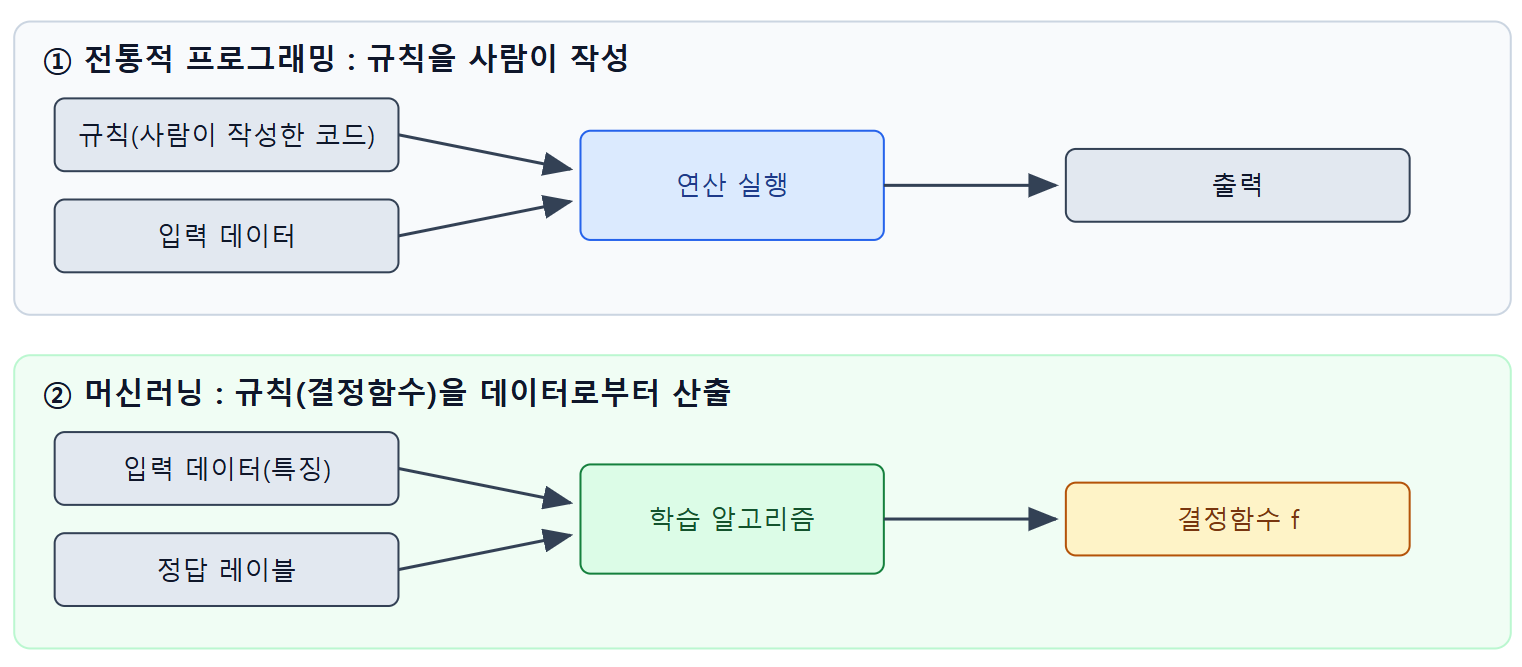
머신러닝의 동작 구조 - 결정함수란? (feat. 악성코드 탐지 예시)

1. 결정함수란 무엇인가1️⃣ 정의결정함수는 입력값을 출력값에 대응시키는 규칙이다. 형식적으로는 입력 공간 X에서 출력 공간 Y로 가는 사상으로 표기한다.f : X → YX : n차원 특징 공간, 입력은 특징 벡터 x = (x1, x2, ..., xn)Y : 출력 공간. 분류 문제라면 {정상, 악성}, 회귀 문제라면 실수 집합 선형 분류기의 경우 결정함수는 다음 형태를 갖는다.f(x) = sign(w1*x1 + w2*x2 + ... + wn*xn + b) 여기서 w는 가중치, b는 편향이다. 학습이 결정하는 대상은 이 w와 b이며, 이를 모델 파라미터라고 한다.입력과 출력의 관계를 연결한다는 의미에서 매핑 함수(Mapping Function) 라는 용어도 동일한 대상을 가리킨다.2️⃣ 일반 프로그램의 함..

[ML 스터디 4주차] 고유값과 고유 벡터 - 특성방정식과 정규화

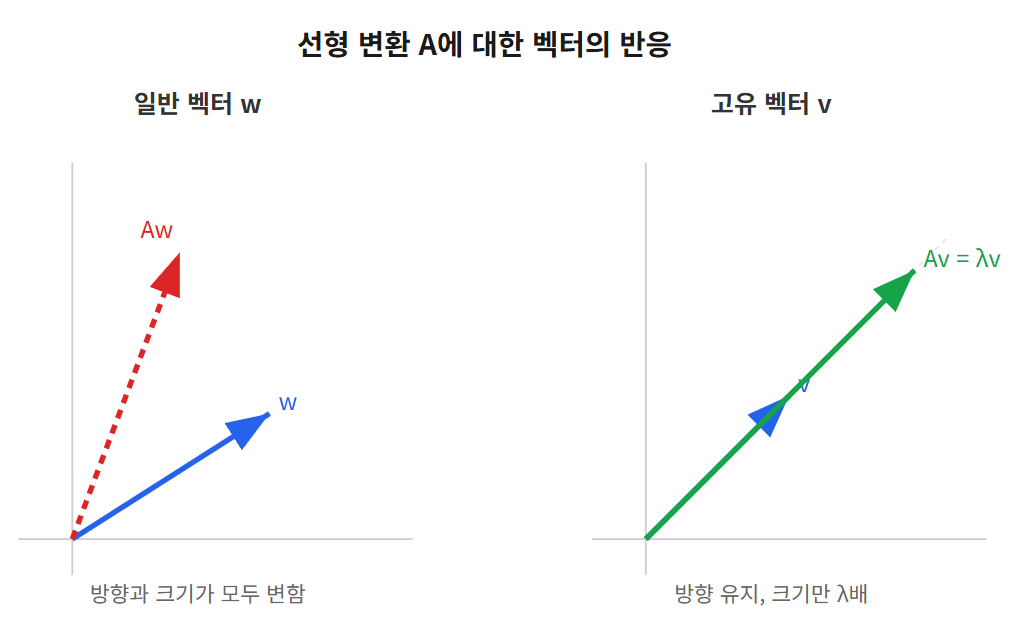
행렬은 벡터에 곱해지면 그 벡터의 크기와 방향을 함께 바꾸는 선형 변환으로 작동한다.그런데 어떤 행렬을 곱해도 방향은 바뀌지 않고 크기만 변하는 특별한 벡터가 존재한다.이 벡터를 고유 벡터, 그 크기 변화의 배율을 고유값이라 부른다. 고유값과 고유 벡터는 PCA(주성분 분석)를 비롯한 머신러닝 기법의 수학적 토대이므로 그 값이 어떻게 계산되어 나오는지 이해해 둘 필요가 있다.1. 고유값과 고유 벡터의 정의1️⃣ 기본 관계식행렬 A에 대해 어떤 벡터 v가 존재하여, A를 곱해도 방향은 바뀌지 않고 크기(스칼라 배수)만 변하는 경우가 있다.이때의 관계식은 다음과 같다.Av = λv여기서 λ(람다)는 고유값(eigenvalue), v는 고유 벡터(eigenvector)다.이 식의 의미는 선형 변환 A를 적용해..

[ML 스터디 4주차] 행렬식(Determinant)의 기하학적 의미

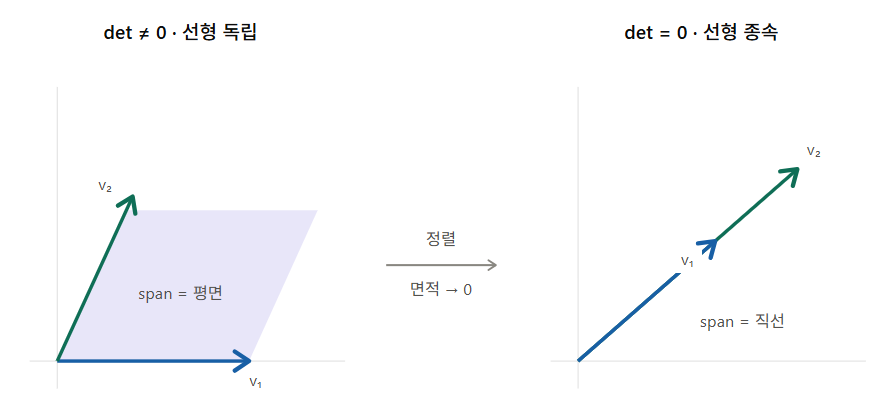
행렬식(Determinant)은 정방행렬 하나에 대응하는 단 하나의 스칼라 값이다.n×n 크기의 정방행렬에 대해서만 정의되며, 행과 열의 개수가 다른 행렬에는 존재하지 않는다.표기는 det(A) 또는 |A|로 한다.2×2 행렬 [[a, b], [c, d]]의 경우 그 값은 ad - bc로 계산된다. 이 값은 연립일차방정식의 해가 존재하는지, 존재한다면 유일한지를 판별하기 위해 고안되었다.행렬식이 0이 아니면 해가 유일하게 존재하고, 0이면 해가 없거나 무수히 많다.이처럼 행렬식은 "해를 결정(determine)한다"는 의미에서 determinant라고 불린다.1. 행렬식은 면적의 변화 배율이다행렬식을 이해하는 가장 직접적인 관점은 "선형 변환을 거쳤을 때 면적 또는 부피가 원래보다 몇 배로 변했는지를 나..

[ML 스터디 4주차] p값과 통계적 유의성의 논리 구조 - 우연인가 진짠가?

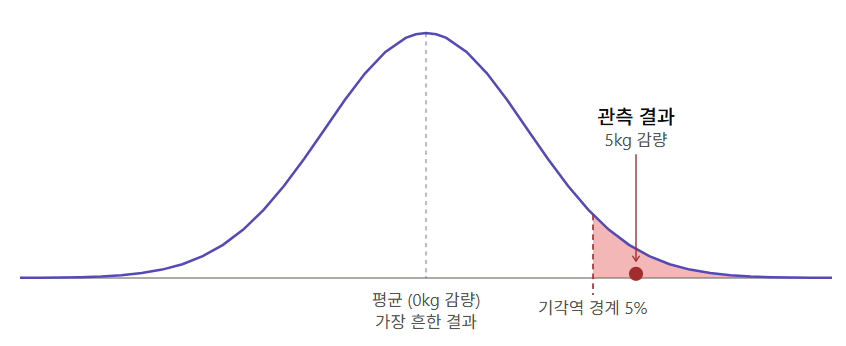
스터디 교재: "개발자를 위한 필수 수학" by 토마스 닐드참고 본문: 116p. 3.5.3 p값 이해하기--------------데이터 분석이나 실험 결과를 마주할 때 반복적으로 등장하는 질문이 있다."이 결과는 진짜 의미가 있는가, 아니면 그저 우연인가." 이 질문에 수학적 근거를 부여하는 도구가 통계적 유의성(Statistical Significance)과 p값(p-value)이다.1. 가설 검정의 세 가지 핵심 개념가설 검정(Hypothesis Testing)은 새로운 주장이나 효과를 검증할 때 사용하는 통계적 절차다. 이 절차는 낙관이 아니라 철저한 의심에서 출발한다. 즉 "효과가 없다"를 기본 전제로 두고, 데이터가 이 전제를 반박할 만큼 극단적인지를 따진다.1️⃣ 귀무가설 (Null Hypo..

[ML 스터디 4주차] 중심 극한 정리와 신뢰 구간 - 표본으로 모집단을 추론

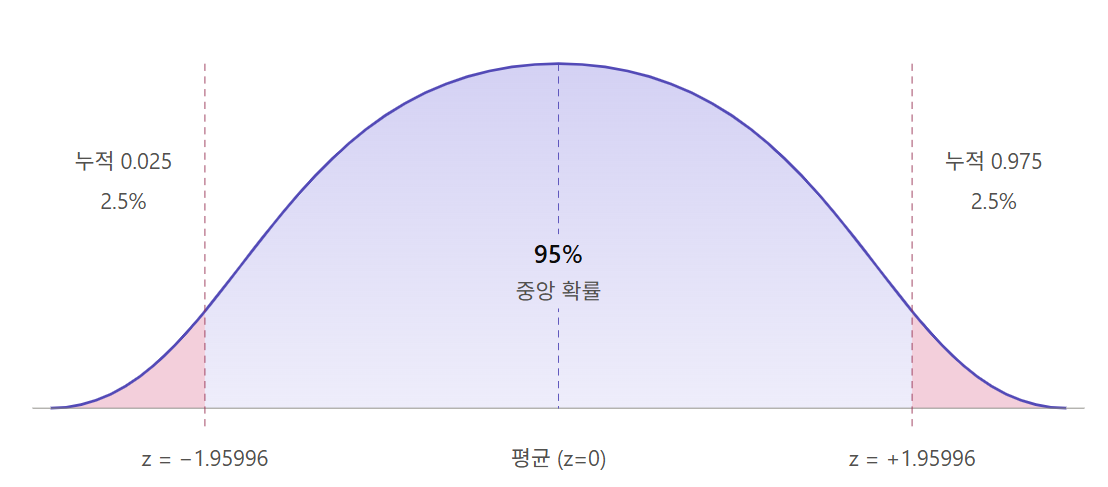
스터디 교재: "개발자를 위한 필수 수학" by 토마스 닐드참고 본문: 112p. 3.5.2 신뢰 구간--------------모집단 전체를 조사하는 일은 대부분의 현실 상황에서 불가능하다.전국의 성인 몸무게, 특정 품종 개의 평균 체중, 서버가 처리하는 응답 시간 전체를 빠짐없이 측정할 방법은 없다.그럼에도 통계학은 일부 표본만으로 모집단의 특성을 추론할 수 있는 근거를 제공한다.그 근거의 핵심에 중심 극한 정리가 있으며, 이 정리 위에서 신뢰 구간이라는 추론 도구가 작동한다.1. 중심 극한 정리: 모집단을 추론하는 이론적 근거1️⃣ 표본으로 전체를 추론한다는 문제세상의 모든 데이터를 측정하는 것은 불가능하다.대한민국 성인 남성 전체의 키, 존재하는 모든 골든 리트리버의 몸무게 같은 모집단 파라미터를 ..

[ML 스터디 3주차] Z스코어 - 서로 다른 분포의 값을 비교하는 방법

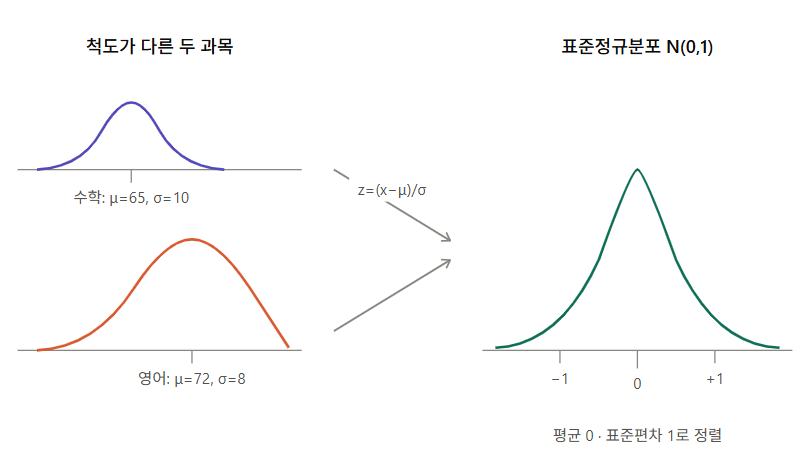
스터디 교재: "개발자를 위한 필수 수학" by 토마스 닐드참고 본문: 107p. 3.4.7 z 점수--------------분포마다 평균과 퍼짐의 정도는 제각각이다.그래서 수학 80점과 영어 85점 중 어느 쪽이 더 잘한 것인지, 과목마다 난이도와 점수 분포가 다르기에 답하기 어렵다.Z스코어(표준점수)는 어떤 값이 자기가 속한 분포의 평균에서 표준편차 몇 개만큼 떨어져 있는지를 계산해, 기준이 서로 다른 값들을 하나의 공통 잣대 위로 옮겨놓는다.1. Z스코어란 무엇인가1️⃣ 값의 위치를 '표준편차 단위'로 환산Z스코어는 하나의 값이 평균으로부터 표준편차 몇 배만큼 떨어져 있는지를 나타내는 수치다. 정의는 다음과 같다. x − μ z = ─────── σ각 기호의 의미는 다음과..

[ML 스터디 3주차] 확률밀도함수(PDF)와 누적분포함수(CDF)

스터디 교재: "개발자를 위한 필수 수학" by 토마스 닐드참고 본문: 102p. 3.4.5 정규분포 - 확률 밀도 함수(PDF)--------------연속형 데이터에서 확률은 점이 아니라 면적으로 존재하며, 이 면적을 왼쪽부터 쌓아 올린 것이 누적 확률이다.1. 확률밀도함수(PDF): 면적 = 확률1️⃣ 연속형 데이터에서 점의 확률은 0이다키, 몸무게, 시간처럼 값이 끊어지지 않고 이어지는 데이터를 연속형 데이터라 부른다.이런 데이터에서는 특정 값이 소수점 끝까지 정확히 일치할 확률이 수학적으로 0에 수렴한다.키가 정확히 175.000...cm인 사람을 특정하는 순간, 그 아래로 무한히 많은 소수점 자리가 존재하기 때문이다.따라서 연속형 데이터의 확률은 하나의 점이 아니라 구간으로 정의해야 한다.곡선..

[ML 스터디 3주차] 표본 분산은 왜 n이 아니라 n-1로 나누는가?

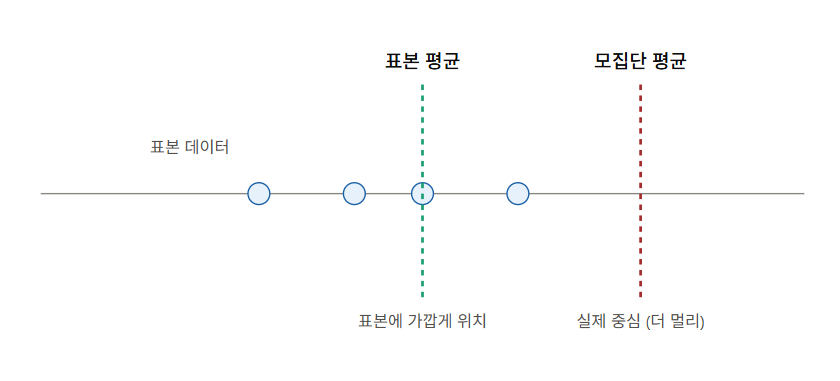
스터디 교재: "개발자를 위한 필수 수학" by 토마스 닐드참고 본문: 97p. 3.4.4 분산과 표준편차--------------1. 모집단과 표본모집단(population)은 분석 대상이 되는 전체 데이터를 뜻한다.예를 들어 대한민국 전체 인구가 모집단이다.표본(sample)은 그중 일부만 뽑아낸 데이터다. 조사를 위해 100명을 뽑았으면, 그 뽑은 100명이 표본이다.전체 데이터를 모두 조사하는 것은 대부분 불가능하므로, 일부를 뽑아 전체를 추정하는 것이 통계의 기본 방식이다.문제는 표본만으로 계산한 분산이 모집단의 실제 분산과 일정한 방향으로 어긋난다는 데 있다.그리고 그 어긋남의 방향은 항상 '실제보다 작게'로 정해져 있다.2. 표본 평균 기준의 편차는 작게 계산된다표본으로 분산을 구할 때, 편..

[ML 스터디 3주차] 분산과 표준편차 - 왜 제곱인가?

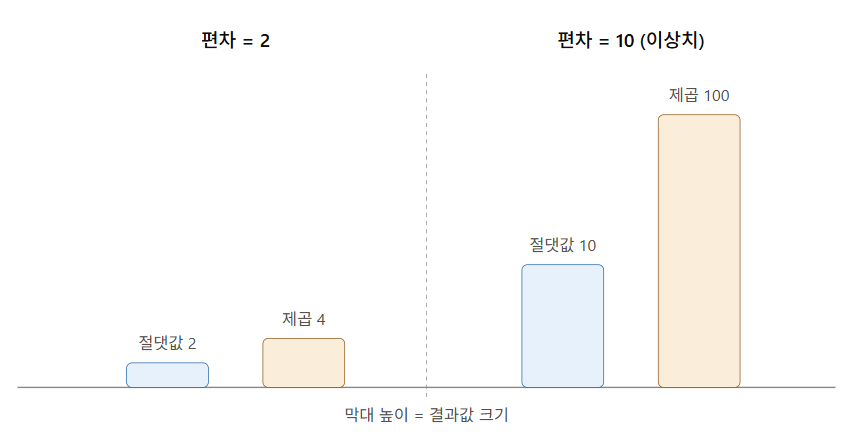
스터디 교재: "개발자를 위한 필수 수학" by 토마스 닐드참고 본문: 94p. 3.4.4 분산과 표준편차--------------1. 분산과 표준편차의 정의1️⃣ 퍼짐을 측정하는 출발점: 평균과의 차이데이터가 얼마나 퍼져 있는지를 측정하려면 각 데이터 값이 평균에서 얼마나 떨어져 있는지를 봐야 한다.가장 직접적인 방법은 각 데이터에서 평균을 빼는 것이다. 이 차이를 편차(deviation)라고 부른다.문제는 여기서 발생한다. 평균보다 큰 데이터는 편차가 양수(+)가 되고, 평균보다 작은 데이터는 편차가 음수(-)가 된다.이 편차들을 그대로 더하면 양수와 음수가 서로 상쇄되어 항상 0이 된다.평균은 데이터의 무게중심이므로, 정의상 편차의 합은 언제나 0이 된다.따라서 편차의 합만으로는 데이터가 퍼진 정도..